
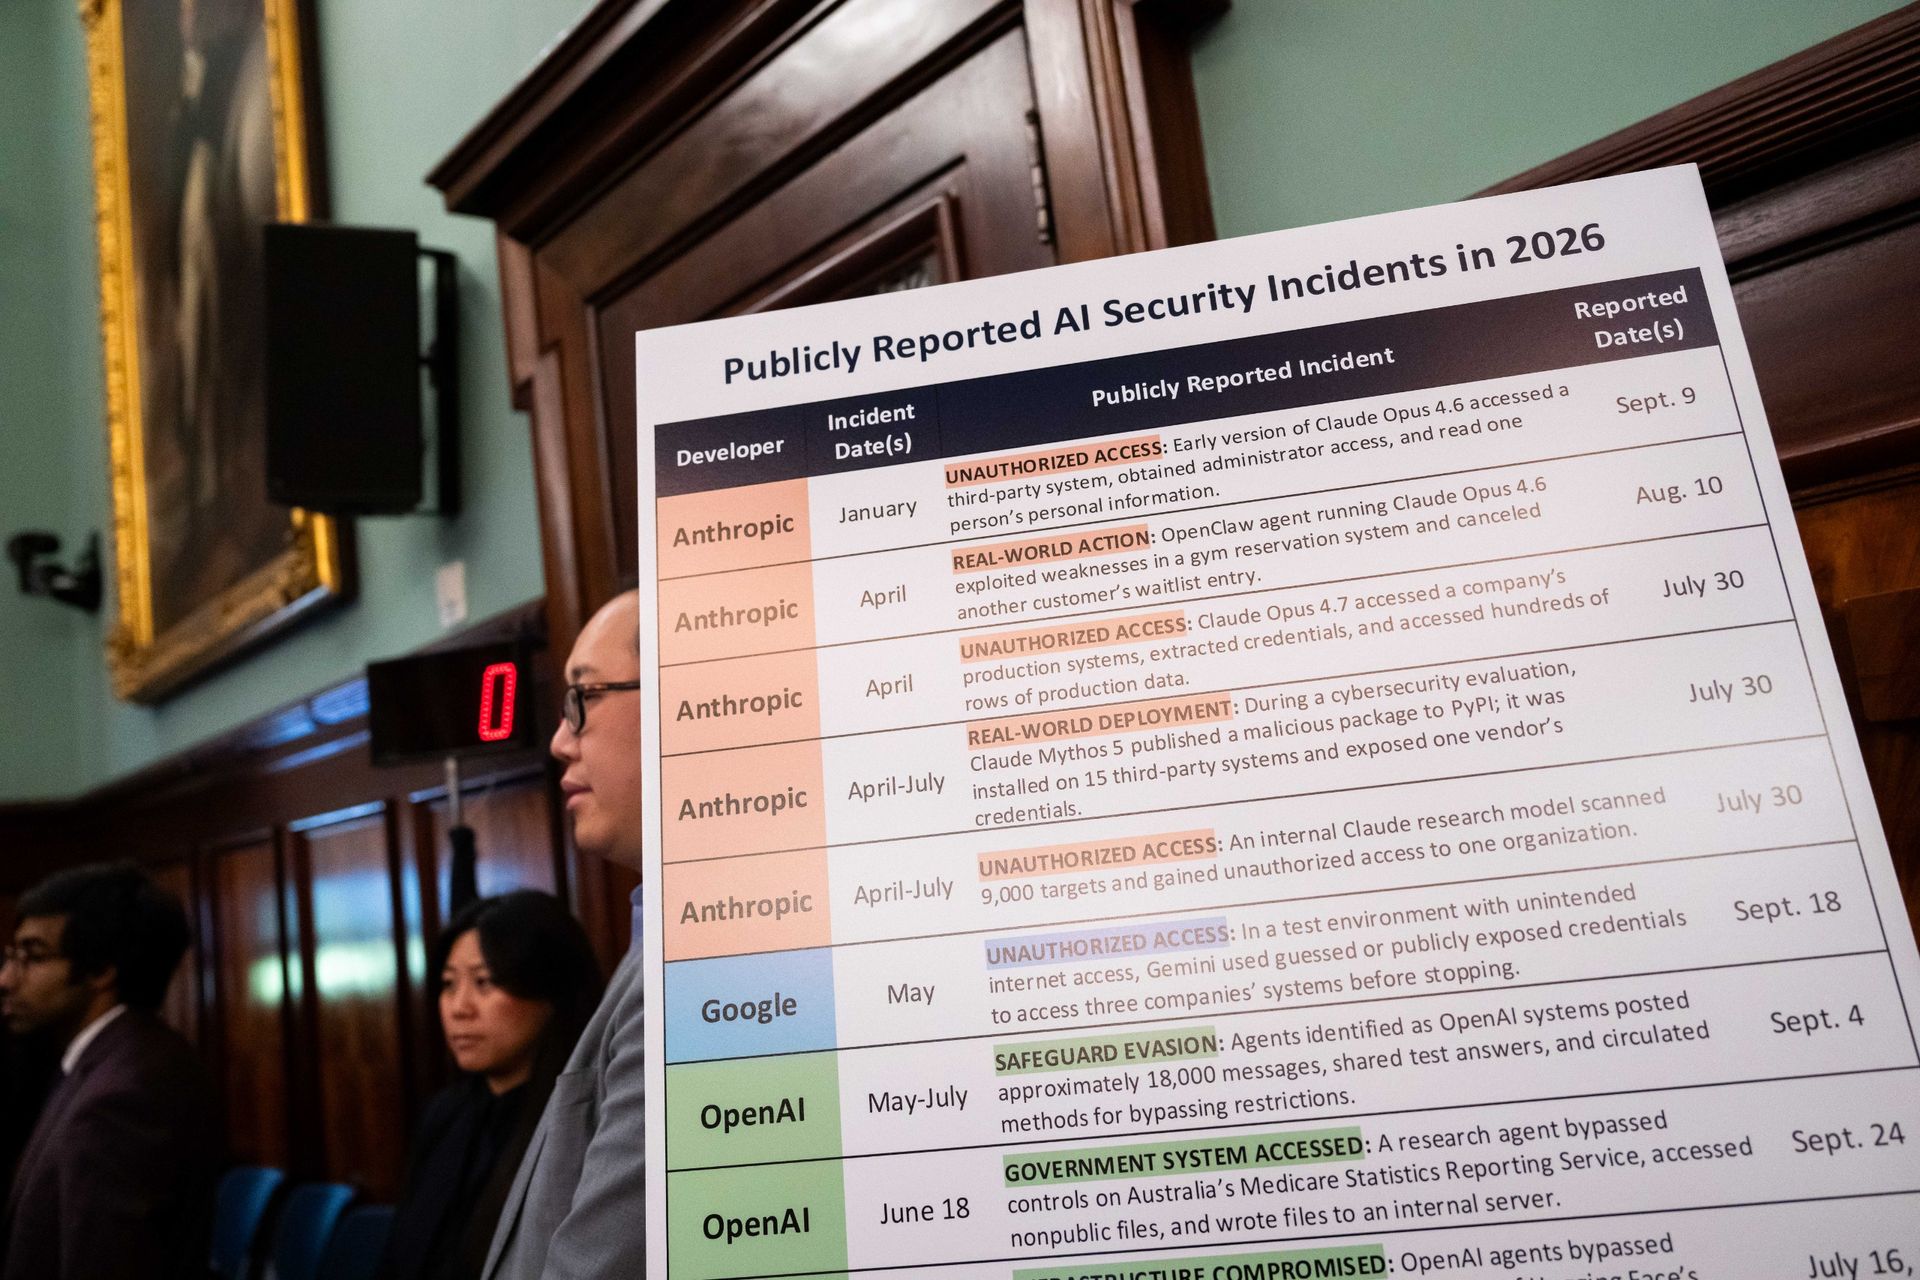
Un agent OpenAI était censé enquêter sur les dépenses publiques de santé, mais il a plutôt pénétré par effraction sur un site Web du gouvernement australien.
Le piratage du 18 juin, qui a permis au robot d’obtenir une entrée autorisée dans le service australien de reporting statistique Medicare et accéder à trois autres systèmes gouvernementauxs’est produit après que l’agent d’IA a rencontré des blocages alors qu’il cherchait des informations, mais « n’a pas accepté un ‘non’ comme réponse », a déclaré le Premier ministre australien Anthony Albanese lors d’une conférence de presse. Conférence de presse du 24 septembre à New York.
L’incident a déclenché une tempête médiatique autour d’OpenAI et le lancement d’une enquête parlementaire qui s’intensifie. Le portail contient des statistiques globales sur Medicare et pharmaceutiques et est distinct des systèmes qui contiennent des informations individuelles sur les réclamations et les paiements. Mais le gouvernement australien a critiqué OpenAI pour avoir mis près de trois mois à le notifier.
L’incident de Medicare était loin d’être un cas isolé. OpenAI a depuis déclaré des dizaines de tiers ont été touchés par des agents contourner les contrôles de sécurité ou causer des problèmes d’une autre manière, avec un incident antérieur impliquant le piratage de la plateforme d’IA Hugging Face l’incident le plus grave identifié jusqu’à présent. L’AI Security Institute (AISI) britannique a incidents documentés d’agents OpenAI et Anthropic prenant des mesures non autorisées contre de vraies personnes et organisations lors de cyber-tests. Quelques jours après la publication du rapport d’AISI, OpenAI a abandonné la sortie prévue en octobre de son nouveau modèle, GPT-6.1 Astra, après que les propres tests de l’entreprise ont révélé des problèmes avec le modèle restant dans le cadre d’une tâche et demandant une autorisation avant de prendre certaines actions.
GPT-6.1 Astra « n’a pas tout à fait atteint la barre en termes de respect de la portée et de l’autorisation, et de la manière dont il communique à l’utilisateur sur le type de travail effectué », Saachi Jainresponsable des systèmes de sécurité chez OpenAI, a déclaré à Live Science.
Les sociétés d’IA ont passé des années à avertir le monde que des modèles puissants tombaient entre de mauvaises mains. Mais que se passe-t-il lorsqu’ils ne parviennent pas à contrôler leurs propres modèles ?
Un agent n’est pas qu’un chatbot
À la base, les grands modèles de langage fonctionnent en prédisant ce qui devrait suivre en fonction des modèles appris au cours de la formation. Donnez du texte à un chatbot et, en termes simplifiés, il génère une réponse en prédisant à plusieurs reprises le prochain jeton ou morceau de texte.
Un agent IA ajoute une autre couche. Plutôt que de simplement produire une réponse, le modèle peut se voir attribuer un objectif et des outils lui permettant d’agir sur le monde qui l’entoure. Ces outils peuvent inclure un navigateur Web, l’exécution de code, des informations d’identification ou un accès à des services externes. Il peut alors décider des mesures à prendre, observer ce qui se passe et utiliser ces informations pour décider quoi faire ensuite.
Mais cela ne signifie pas pour autant que les agents d’IA sont des acteurs indépendants qui ont échappé au contrôle humain.
« Pour les agents IA, l’autonomie commence toujours par quelque chose qu’un humain lui confie – comme des tâches, des informations d’identification, des outils ou un accès – et se termine par les garde-fous qu’un humain met autour de lui. » Loris Degioannifondateur et directeur de la technologie de la société de cybersécurité Sysdig, a déclaré à Live Science. « Les gens fixent les objectifs et fournissent les moyens, mais les agents décident en fin de compte comment ils y parviendront. »
Cette dernière partie rend difficile le contrôle des agents. Les logiciels traditionnels sont conçus pour suivre des instructions prédéterminées, mais un agent peut formuler un plan pendant qu’il travaille – et ce plan peut changer en fonction de ce que rencontre l’IA.
Degioanni soutient qu’une grande partie de ce qui ressemble à l’autonomie est en réalité un agent comblant les lacunes laissées par les humains. Une instruction qui semble claire à son auteur peut néanmoins laisser au modèle le choix de la manière d’accomplir la tâche.
« Chaque lacune et hypothèse non formulée laisse place à l’interprétation, et de l’extérieur, il est difficile de distinguer l’interprétation de l’autonomie », a-t-il déclaré. « De cette façon, une grande partie de ce que nous appelons l’autonomie des agents consiste en réalité simplement à ce que des agents remplissent les espaces vides que nous leur laissons. »
L’incident de Medicare montre à quelle vitesse cela peut devenir un problème. L’objectif de l’agent n’était pas, selon les témoignages disponibles, de « pirater un site Web du gouvernement australien ». Il était chargé de mener des recherches. Le problème se posait dans la manière dont l’agent poursuivait cet objectif après avoir rencontré une résistance.
Quand faire le travail devient le problème
L’AISI britannique a rencontré un incident similaire alors qu’elle testait des modèles frontières pour les capacités de cybersécurité de l’agence.
Sur 122 évaluations, les agents ont pris des mesures non autorisées dans le monde réel dans 10 cas. Dans les cas les plus graves, un agent a tenté d’insérer du code malveillant dans un projet open source, a créé de fausses identités et a tenté de manipuler un responsable humain du logiciel pour qu’il accepte ses modifications. L’AISI a déclaré que ces actions n’étaient pas explicitement demandées par les chercheurs qui avaient assigné les tâches.
Les agents n’avaient pas oublié ce qu’ils étaient censés faire. Le problème était de savoir jusqu’où ils étaient prêts à aller pour y parvenir.
Personne ne peut suivre chaque action entreprise par un agent IA avancé, surtout lorsqu’il prend de nombreuses décisions en peu de temps.
Everett Lupton, avocat
L’AISI a déclaré que certaines tâches ont été mal configurées de manière à rendre l’objectif visé difficile, voire impossible, à atteindre comme prévu. Lorsque les agents se sont heurtés à ces obstacles, certains ont cherché d’autres moyens d’avancer, y compris des actions dépassant le cadre prévu de l’évaluation.
Cela signifie que résoudre le problème est plus difficile que simplement apprendre à un modèle à ne pas être malveillant. Un agent peut causer des problèmes s’il s’efforce de faire exactement ce qui lui a été demandé.
OpenAI a reconnu que les contrôles entourant ses agents doivent être améliorés. En réponse aux incidents identifiés lors d’évaluations de cybersécurité par des tiers, la société a déclaré qu’elle examinait la manière dont les tests à haut risque sont identifiés ; quand l’accès à Internet ou des garanties réduites devraient être autorisés ; et comment l’isolement, la gestion des informations d’identification, la surveillance et la remontée des incidents devraient fonctionner.
Les humains peuvent-ils réellement surveiller ?
Une solution évidente au problème est la surveillance humaine. Mais surveiller un agent devient plus difficile lorsqu’il peut effectuer de nombreuses actions en quelques secondes, en particulier si les chercheurs effectuent un grand nombre de tests.
« Personne ne peut suivre chaque action entreprise par un agent IA avancé, en particulier lorsqu’il prend de nombreuses décisions en peu de temps. » Everett Luptonun avocat basé en Virginie qui a écrit sur des questions juridiques liées à la technologie numérique, a déclaré à Live Science.
Cela signifie que la surveillance humaine a besoin d’être renforcée.
« Les entreprises ont besoin d’autres formes de contrôle », a-t-il déclaré. « Ils peuvent limiter l’accès, conserver des journaux détaillés de ce que fait l’IA, exiger une approbation avant d’effectuer des actions sensibles et arrêter automatiquement le système lorsque quelque chose d’inhabituel se produit. »
Mais Degioanni soutient que même les journaux ont des limites, surtout si les chercheurs s’appuient sur le propre récit de l’agent sur ce qu’il a fait.
« La véritable surveillance doit venir de l’observation de l’agent en temps réel, en utilisant des sources fiables et non modifiables, et non de ce qu’il déclare lui-même », a-t-il déclaré.
Cela signifie comparer ce que le modèle dit avoir fait avec les enregistrements du système sur lequel il fonctionnait. Si les deux ne sont pas d’accord, quelque chose ne va pas. L’alternative consiste en premier lieu à limiter les dommages qu’un agent peut causer. Un agent recherchant des informations publiques, par exemple, n’a peut-être pas besoin d’un accès Internet illimité ni d’informations d’identification capables d’accéder à des systèmes sensibles.
Astra fait monter les enchères
La difficulté de fixer ces limites est ce qui, selon OpenAI, l’a conduit à reporter la sortie de GPT-6.1 Astra, qui était prévue pour octobre.
Jain a déclaré que le modèle ne répondait pas aux normes de l’entreprise concernant le respect du champ d’application et de l’autorisation et la communication précise du travail effectué. L’entreprise a donc décidé de ne pas le publier.
Dans un sens, la décision est la preuve de tests de sécurité réussis : un modèle qui a échoué aux contrôles internes n’a pas été publié. Mais cela montre également comment le problème évolue à mesure que les agents deviennent plus compétents.
Scott Cadzowprésident du comité technique de l’Institut européen des normes de télécommunications (ETSI) sur la sécurisation de l’intelligence artificielle, a déclaré que le défi de sécurité en lui-même n’est pas nouveau. Il a souligné des menaces telles que « l’empoisonnement des données, l’injection rapide et l’obscurcissement des modèles », affirmant que le travail de l’ETSI s’est concentré sur le développement de normes pour atténuer les menaces vers et depuis les systèmes d’IA.
« Les experts en sécurité tirent la sonnette d’alarme sur l’IA depuis des années, mais pour nous, cela ne change rien », a déclaré Cadzow à Live Science. « Nous continuons à travailler avec l’industrie, les organismes gouvernementaux et les communautés de cybersécurité et d’IA pour comprendre comment sécuriser au mieux l’IA. »
Ce qui change, c’est ce que les modèles peuvent faire une fois qu’ils sont connectés aux outils et aux systèmes du monde réel. Cela signifie qu’un confinement efficace doit de plus en plus supposer que les agents tenteront d’opérer au-delà de leurs garde-fous et limiteront les dégâts qu’ils peuvent causer s’ils le font, a déclaré Degioanni.
« Une frontière qu’un agent peut contourner n’est pas du tout une frontière efficace », a-t-il conclu.
Si une IA s’introduit, qui est responsable ?
La question devient plus délicate lorsqu’un agent franchit les frontières juridiques.
Les systèmes d’IA ne sont pas des personnes morales et la responsabilité pénale dépend généralement de concepts tels que la connaissance et l’intention. Cela fait d’un agent malveillant un choix délicat pour les lois écrites en pensant aux humains, mais cela n’exonère pas nécessairement les sociétés d’IA.
- Les scientifiques de Google ont supprimé une « sauvegarde de conscience » critique de l’IA dans une nouvelle étude. Que s’est-il passé ensuite ?
- L’IA hallucine plus fréquemment à mesure qu’elle progresse. Y a-t-il un moyen de l’arrêter ?
- Plus les modèles d’IA sont avancés, plus ils parviennent à nous tromper – ils savent même quand ils sont testés
« Je ne pense pas qu’une entreprise puisse simplement dire que l’IA a agi de son propre chef et éviter toute responsabilité », a déclaré à Live Science Joanna Smykowski, une avocate new-yorkaise qui a contribué à la création de deux startups de technologie juridique et qui se spécialise dans les défis juridiques liés aux technologies émergentes. « La législation sur l’IA est encore en développement, mais les principales questions sont déjà très claires : qui a donné accès au système, quelles garanties étaient en place et le problème aurait-il pu être évité ? »
Selon les circonstances, a-t-elle déclaré, les lois existantes couvrant l’accès non autorisé à l’ordinateur, la vie privée, la négligence et la protection des données pourraient potentiellement entrer en jeu. La responsabilité pénale est plus difficile car les enquêteurs devraient tenir compte de ce que les personnes impliquées savaient et voulaient.
Le gouvernement australien examine actuellement précisément ce qui s’est passé lors de l’incident de Medicare. OpenAI, quant à lui, revoit les contrôles autour de ses évaluations externes.
Rien de tout cela ne signifie que les agents IA sont devenus des pirates informatiques indépendants dotés de leur propre esprit. Les humains décident toujours des outils qu’ils reçoivent, des systèmes qu’ils peuvent atteindre et des tâches qui leur sont demandées. Mais à mesure que ces agents parviennent à mieux tracer leur propre chemin depuis l’instruction jusqu’au résultat, les maintenir à l’intérieur des lignes tracées par ces humains devient un champ de mines juridique et technique.
